Interviews mit Patient:innen, vertrauliche Unternehmensdaten, Gespräche mit vulnerablen Gruppen: Bei einigen qualitativen Forschungsdaten möchten Sie womöglich nicht, dass diese das eigene Haus verlassen. Genau dafür gibt es lokale KI-Modelle in MAXQDA. Damit können Sie unsere KI-Funktionen von AI Assist mit einem Sprachmodell auf Ihrem eigenen Computer oder einem Server Ihrer Organisation nutzen. Ihre Daten bleiben so jederzeit bei Ihnen in Ihrem Netzwerk und Sie arbeiten weiter mit den gewohnten KI-Funktionen von AI Assist, direkt in ihrer Projektdatei.
In diesem Beitrag erfahren Sie, warum sich lokale KI-Modelle für Ihre Forschung lohnen. Außerdem zeigen wir Ihnen, wie Sie AI Assist mit lokalen KI-Modellen einrichten und wie Sie das passende Modell für Ihren Computer finden.
Warum lokale KI-Modelle für Ihre Forschung sinnvoll sind
Manche Forschungsdaten sollen Ihren Computer oder Ihre Einrichtung gar nicht erst verlassen oder Ihre Einrichtung erlaubt grundsätzlich keine cloudbasierten Tools. Für genau diese Fälle gibt es in MAXQDA die Möglichkeit, AI Assist mit lokalen KI-Modellen zu verbinden. So können Sie alle Funktionen von AI Assist verwenden, ohne Ihre Daten an eine Cloud zu schicken.
Es gibt eine Reihe von Gründen, die für lokale KI-Modelle sprechen:
- Volle Kontrolle über Ihre Daten: MAXQDA sendet Ihre AI Assist-Anfragen an das lokale Modell. Die Daten, mit denen Sie arbeiten, bleiben auf Ihrem Computer oder im Netzwerk Ihrer Organisation.
- Gewohnte Arbeitsweise: Alle Funktionen von AI Assist nutzen Sie wie bisher. Sie starten sie über dieselben Menüs und die Ergebnisse landen an denselben Stellen – ob AI Chat, AI Summarys oder AI Coding.
- Kein Tageslimit: Anfragen an Ihr lokales KI-Modell zählen nicht zu Ihrem täglichen AI Assist-Limit.
- Freie Modellwahl: Sie entscheiden selbst, welches Sprachmodell AI Assist verwendet, und können es jederzeit wechseln. MAXQDA funktioniert mit jedem Modellserver, der mit der OpenAI-API kompatibel ist.
- Flexibel zwischen lokalen Modellen und Cloud wechseln: Für anspruchsvolle Aufgaben wechseln Sie jederzeit zurück zu AI Assist in der Cloud.
- Zentral bereitstellbar: Ihre Organisation kann lokale KI-Modelle für alle Nutzenden einrichten und verwalten. Sie selbst müssen in diesem Fall nichts konfigurieren.
Was Sie realistisch erwarten können
Lokale Modelle sind ein Gewinn an Kontrolle, kein Ersatz für die Leistung der Cloud. Die Ergebnisse sind in der Regel weniger genau als mit AI Assist in der Cloud und die Antworten dauern etwas länger. Der Grund: Die Cloud-Modelle sind weitaus größer und leistungsfähiger und AI Assist ist genau auf sie abgestimmt.
Wie gut ein lokales Modell arbeitet, hängt deshalb stark vom gewählten Modell und Ihrer Hardware ab. Das gilt auch für die Sprache: Welche Sprachen Sie nutzen können, bestimmt das Modell, nicht MAXQDA. Und wie immer bei AI Assist gilt: Die KI liefert Vorschläge, die analytische Entscheidung treffen Sie.
Was Sie für lokale KI-Modelle in MAXQDA brauchen
Die Voraussetzungen sind überschaubar. Sie benötigen zwei Dinge:
- AI Assist Premium: Lokale KI-Modelle sind in diesem Add-on enthalten. Mit AI Assist Free können Sie direkt im Bereich „Lokale KI-Modelle“ der Einstellungen upgraden.
- Einen Modellserver: Er führt das Sprachmodell aus und stellt es MAXQDA zur Verfügung. Dafür eignen sich kostenlose Apps wie Jan, LM Studio oder Ollama auf Ihrem Computer. Alternativ kann Ihre Organisation einen Server bereit stellen.
Tipp: Hat Ihre Organisation lokale KI-Modelle zentral eingerichtet, sehen Sie Server und Modell bereits im Bereich „Lokale KI-Modelle“. Die Funktion ist dann aktiv und Sie können sofort loslegen.
In wenigen Schritten eingerichtet
Sie möchten das Modell auf Ihrem eigenen Computer betreiben? Dann installieren Sie zunächst eine App wie z. B. Jan. Dort laden Sie ein Sprachmodell herunter und starten den lokalen API-Server. Anschließend verbinden Sie MAXQDA mit dem Modell:
- Öffnen Sie Einstellungen > Lokale KI-Modelle.
- Geben Sie unter Serveradresse die Adresse aus Ihrer App oder von Ihrer IT-Administration ein. Endet sie auf „/v1“, lassen Sie diesen Teil weg.
- Tragen Sie bei Bedarf einen API-Key ein. Verlangt Ihr Server keinen, bleibt das Feld leer.
- Klicken Sie auf Testen und Modelle finden. Sobald der Status „Server verfügbar“ anzeigt, wählen Sie unter Modell ein Sprachmodell.
- Legen Sie unter Timeout für KI-Antworten fest, wie lange MAXQDA auf eine Antwort wartet. Standardmäßig sind es 3 Minuten.
- Klicken Sie auf Zum selbstgehosteten AI Assist wechseln.
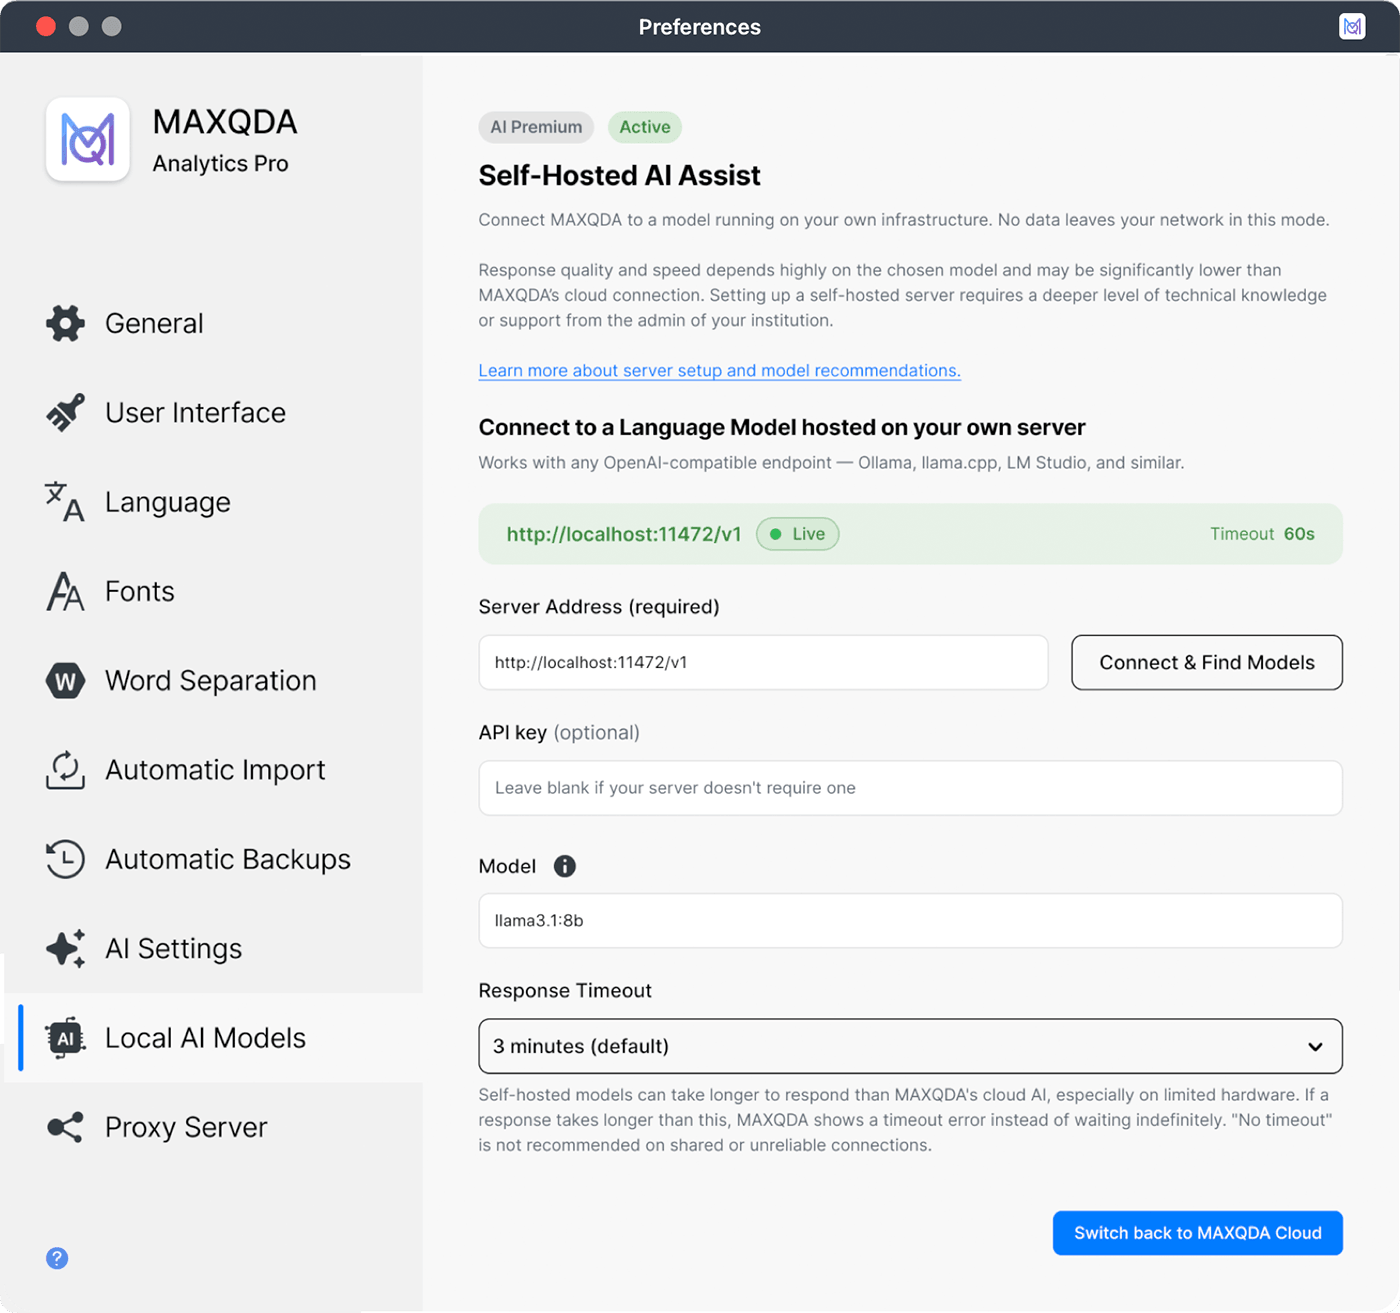
Ab jetzt gehen alle AI Assist-Anfragen an Ihr lokales Modell. Bei der ersten Nutzung bestätigen Sie, dass MAXQDA Ihre Daten an die konfigurierte KI-Verbindung sendet. Lassen Sie die Server-App dabei geöffnet. Sonst kann AI Assist nicht antworten.
Tipp: Antwortet Ihr Modell häufig nicht rechtzeitig, erhöhen Sie das Timeout oder wählen Sie ein kleineres, schnelleres Modell. Die Schritt-für-Schritt-Anleitung finden Sie im Manual unter Voraussetzungen und Einrichtung.
So finden Sie das passende lokale Modell
Die Wahl des Modells entscheidet darüber, wie gut und wie schnell AI Assist lokal arbeitet. Die richtige Wahl hängt von zwei Fragen ab: Was schafft Ihr Computer, und welche AI Assist-Funktionen nutzen Sie am häufigsten?
Welche Funktion welches Modell braucht
Nicht jede Funktion stellt dieselben Anforderungen an die Modelle:
| Anforderung | Funktionen | Was das Modell können muss |
|---|---|---|
| Gering | Text übersetzen | Funktioniert mit fast jedem Modell gut |
| Mittel | AI Chat, AI Summarys | Anweisungen zuverlässig befolgen |
| Hoch | AI Coding | Ihre Codedefinitionen konsistent anwenden – hier lohnt sich das leistungsfähigste Modell |
Beachten Sie außerdem: Ein lokaler Server arbeitet Anfragen meist nacheinander ab. Wenn Sie zehn Dokumente mit AI Coding codieren, kann das etwa zehnmal so lange dauern wie bei einem einzelnen Dokument.
Speicher ist die wichtigste Grenze
Das Modell muss in den Arbeitsspeicher Ihres Computers oder in den Speicher Ihrer Grafikkarte passen – mit Reserve. Als Faustregel gilt: Halten Sie etwa 20 % frei. Hilfreich zu wissen:
- Modellgröße: Sie wird in Parametern angegeben, zum Beispiel 7B (7 Milliarden) oder 30B. Größere Modelle liefern meist bessere Ergebnisse, brauchen aber mehr Speicher.
- Quantisierung: Komprimierte Versionen sind mit Q2 bis Q8 gekennzeichnet. Wählen Sie Q4 oder höher; Q4 und Q5 sind für die meisten Computer ein guter Kompromiss. Ein 30B-Modell mit Q4 schlägt in der Regel ein 15B-Modell mit Q8.
- Hardware: Eine Grafikkarte mit viel eigenem Speicher (etwa 12 GB oder mehr) beschleunigt die Antworten. Macs mit Apple Silicon können dank gemeinsamem Speicher oft größere Modelle ausführen. Ohne geeignete Grafikkarte laufen eher kleinere Modelle (etwa 7B bis 9B) mit längeren Wartezeiten.
Tipp: Wählen Sie für AI Assist ein Modell ohne Reasoning oder stellen Sie das Reasoning auf eine niedrige Stufe. „Denkende“ Modelle verlängern beim Zusammenfassen, Übersetzen oder Chatten die Wartezeit erheblich.
Ihre Checkliste für die Modellwahl
- Prüfen Sie, wie viel Speicher Ihr Computer hat, und planen Sie etwa 20 % Reserve ein.
- Wählen Sie das größte aktuelle Modell, das mit Q4 oder höher passt. Jan und LM Studio schlagen Ihnen passende Modelle für Ihre Hardware vor.
- Vergleichen Sie Modelle vorab in unabhängigen Benchmarks wie Artificial Analysis. Ein aktuelles kleines Modell kann ein älteres großes übertreffen.
- Testen Sie das Modell zuerst mit einer einfachen Funktion wie „Text erklären“, dann mit den Funktionen, die Sie am häufigsten nutzen.
- Sind die Ergebnisse zu langsam oder nicht gut genug, probieren Sie ein anderes Modell oder eine andere Quantisierung aus.
Weitere Details lesen Sie in unserem Online-Manual unter Modell auswählen.
KI-Unterstützung ohne Kompromisse beim Datenschutz
Mit lokalen KI-Modellen verbinden Sie KI-Unterstützung und den Schutz sensibler Daten. Sie bestimmen jederzeit selbst, wo Ihre Daten verarbeitet werden und Sie arbeiten trotzdem weiter mit den vertrauten Funktionen von AI Assist direkt in MAXQDA. Für besonders anspruchsvolle Aufgaben können Sie mit nur einem Klick zurück in die Cloud wechseln und so jederzeit die Modelle ihren Bedürfnissen anpassen.